
编辑:前沿在线 编辑部
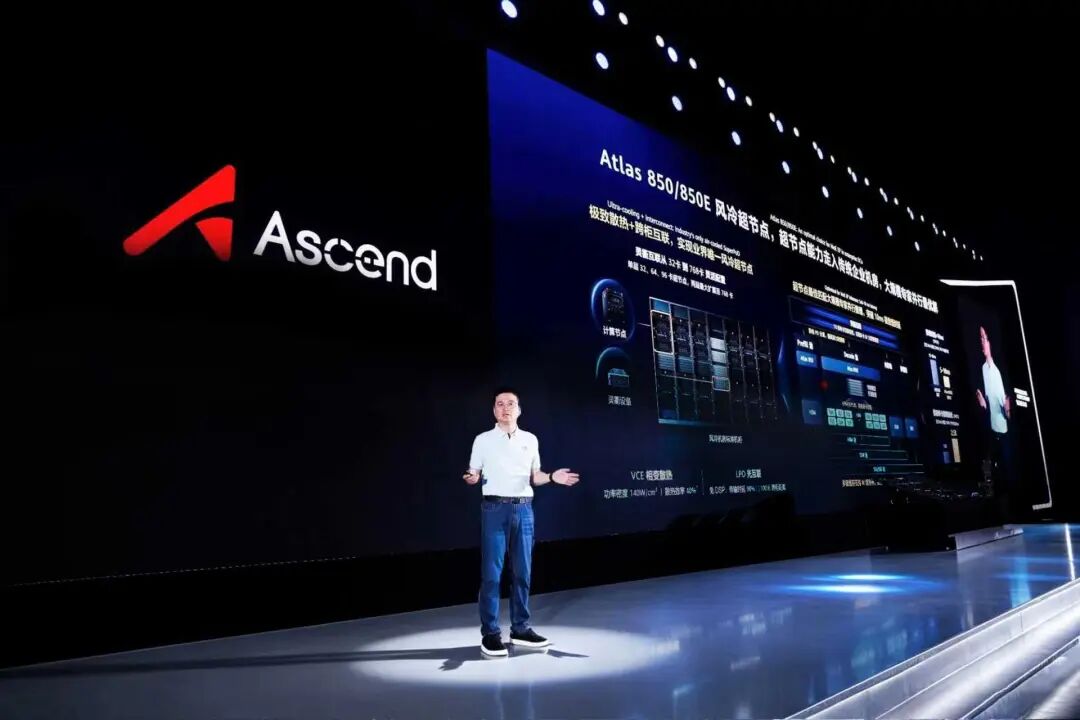
华为全联接大会2026——昇腾AI人工智能产业峰会上,昇腾950 超节点的正式上市,在算力圈激起的讨论远不止一款新品本身。
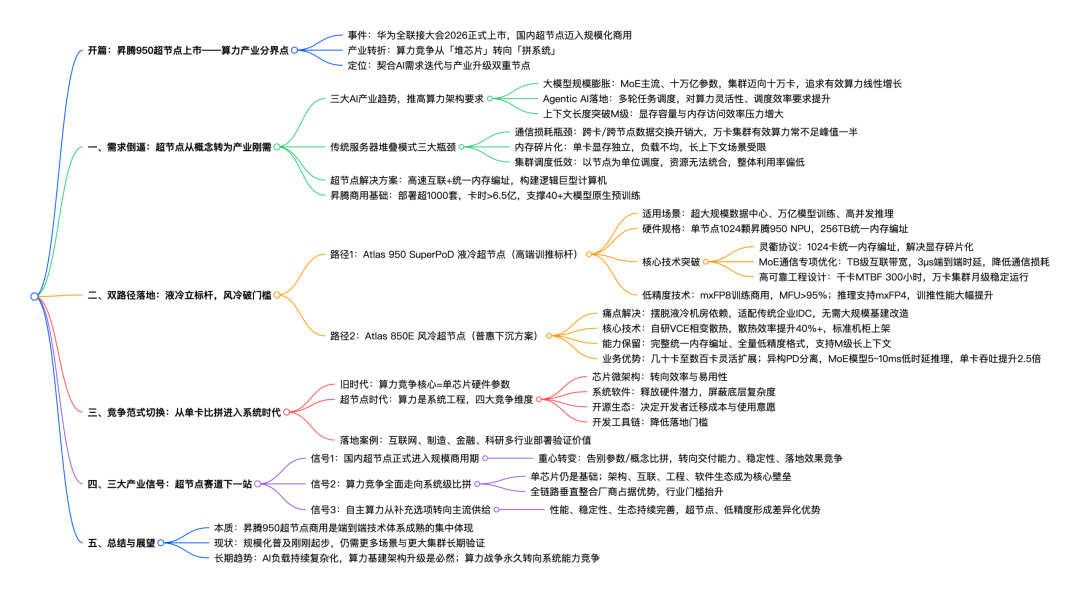
在我们看来,这更像是国内超节点算力产业的一个分界点:在此之前,超节点大多停留在试点验证、小范围落地的阶段;在此之后,规模化商用的大幕正式拉开。更深层的变化在于,算力行业持续了多年的“堆芯片” 竞赛,正在悄然转向 “拼系统” 的全新阶段。
放在AI 产业演进的大坐标系里看,这一步踩在了需求迭代的节点上,也踩在了产业升级的节点上。
超节点从技术圈的前沿话题,变成全行业共同的技术演进方向,本质上是AI负载迭代演变的结果。近两年大模型产业的快速演进,已经从根本上改变了算力需求的形态,传统算力建设模式的天花板越来越明显。
当前三个产业趋势已经非常清晰,共同推高了对算力架构的要求。
一是大模型规模持续膨胀,MoE架构成为主流,十万亿参数级模型逐步增多,集群规模从万卡向十万卡级延伸,如何保持有效算力的线性增长,成为全行业共同的课题;
二是Agentic AI从概念逐步落地,多轮调用、复杂任务调度对算力的灵活性与调度效率要求陡增;
三是上下文长度持续向M级突破,对内存容量与访问效率的要求持续拉高。
在这样的需求背景下,传统靠服务器堆叠的算力建设模式,已经实实在在撞上了效率天花板,行业面临三个共性的发展瓶颈。
首当其冲是通信损耗瓶颈。
MoE模型的专家路由机制,需要高频跨卡、跨节点交换数据,传统集群互联带宽不足、协议栈开销高,计算单元大量时间处于等待数据的状态。
集群规模越大,有效算力折损越严重,到万卡级别,业内普遍认为有效算力往往不足峰值的一半,成为制约大模型训练效率的核心因素。
其次是内存碎片化问题。
单卡显存是固定的物理上限,传统模式下各卡显存独立调度,无法跨卡共享,经常出现部分卡显存占满、部分卡显存闲置的负载不均情况,在长上下文场景下,这个矛盾尤其突出,直接限制了模型可处理的上下文规模。
最后是集群调度低效。
传统算力集群的资源调度基本以节点为单位,跨节点的算力、内存、通信资源很难实现统合调配,负载不均衡是行业常态,集群整体资源利用率长期处于偏低水平。
正是在这样的产业背景下,超节点成为行业公认的技术演进方向。
通过高速互联与统一内存编址,将分散的算力单元整合成一台逻辑上的巨型计算机,从架构层面解决上述三大瓶颈,从根源上提升集群效率。
这也是近两年国内外主流算力厂商纷纷布局超节点的核心原因——不是概念炒作,是产业需求发展到了这个阶段。
在此之前,国内超节点产业大多处于原型验证与小范围试点阶段,部署规模小、覆盖场景有限,尚未形成成熟的商用方案。
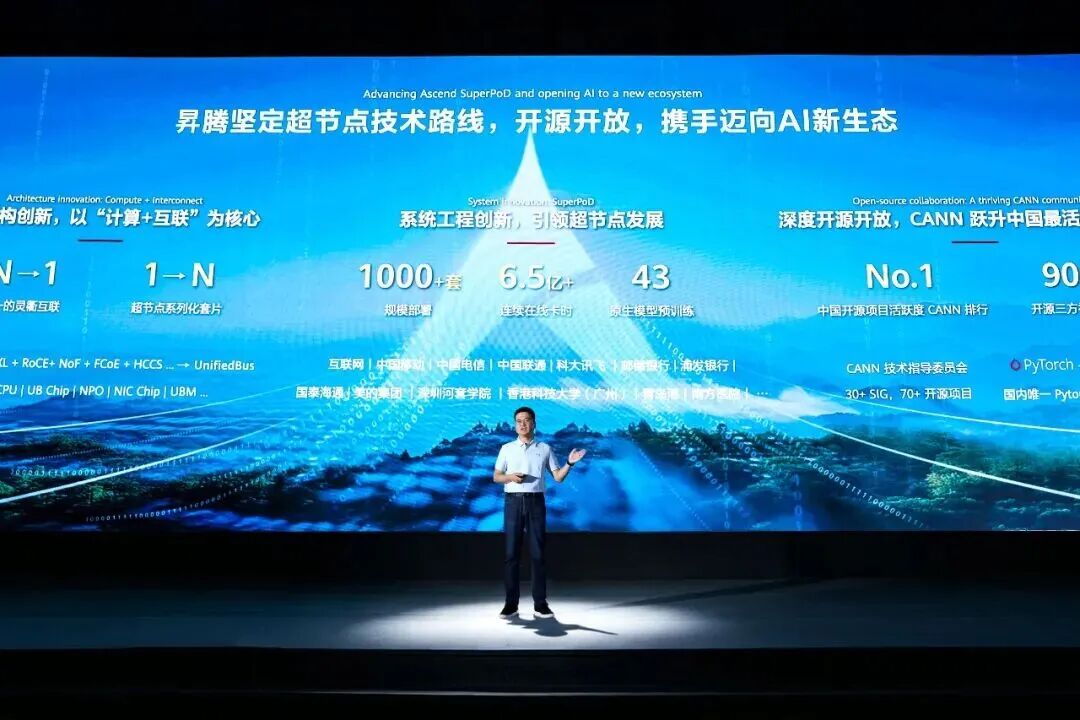
昇腾超节点作为国内唯一规模商用的超节点,截至目前部署规模已超1000套,累计在线卡时超过6.5亿,支撑40多个大模型完成原生预训练,为整个产业完成了初步的技术与商业验证。
如果说此前昇腾950超节点在WAIC亮相还处于技术展示阶段,那么这次在华为全联接大会2026上的正式上市,则标志着这款产品正式迈入规模化商用落地阶段。
从昇腾在峰会上放出的产品矩阵,能看到当前超节点产业的两个主要落地方向:
一个是向超大规模训推场景做工程化深耕,立住商用标准;
一个是向传统企业机房做适配性下沉,打开普及空间。两条路径同时推进,共同拓宽超节点的产业边界。
液冷超节点:工程化能力定义高端商用标准
Atlas 950 SuperPoD 液冷超节点,面向的是超大规模数据中心建设、万亿级大模型训练与中心高并发推理场景,也是目前业界规模较大的商用超节点方案。
在我们看来,这类产品的核心价值不止是参数指标的刷新,更在于验证了万卡级超节点的工程化可行性与商用成熟度。
根据官方披露的技术参数,单个超节点集成1024颗昇腾950 NPU,支持256TB统一内存编址,核心能力围绕大带宽互联、低时延通信、跨节点统一内存编址展开。
其核心突破精准命中了前文提到的行业三大瓶颈:
一是通过灵衢协议实现1024 卡统一内存编址,跨卡远程内存访问体验接近本地,从架构层面解决了显存碎片化、负载不均的问题;
二是针对MoE专家路由场景做了通信库专项优化,结合物理层带宽升级,最终实现TB级互联带宽与3μs端到端时延,大幅消解跨节点通信损耗,让万卡级集群的有效算力不再大幅折损。
更值得产业关注的是工程化落地的可靠性价值。
对万卡级大模型训练来说,集群稳定本身就是核心效率—— 一次训练意外中断,可能造成数天甚至数周的算力损失与进度延误。
该方案通过架构精简与光模块技术优化,大幅压缩了互联层级与中间环节,最终让千卡集群MTBF达到300小时,搭配器件、网络、系统三重高可靠设计,可支撑万卡级集群实现月级稳定运行。
这意味着超大规模训练任务的停机风险显著降低,算力交付的确定性大幅提升,也给行业提供了万卡级超节点工程落地的参考标准。
低精度技术的成熟同样具备产业意义。
作为国内唯一实现mxFP8低精训练商用落地的技术路线,昇腾950芯片原生支持该格式,核心算子MFU达95%以上,通过3万+ 泛化样本与正反向组合验证,实现全场景精度误差小于0.5%,极致场景小于0.2%,一定程度上打消了行业对低精训练损失精度的普遍顾虑。
推理侧全流程支持mxFP4,全链路精度误差小于1%。 最终落地的效果是训MFU提升1.5~1.7倍,推理性能提升2~3倍,最低可实现5ms低时延,基本能够支撑万亿、十万亿大模型的高效训推需求。
整体来看,这类高端超节点方案的成熟,给整个行业提供了一个万卡级超节点的商用参考样本,让超大规模超节点从技术可行性,变成了可落地、可验证、可规模化的基建方案。
风冷超节点:打破部署门槛打开普惠空间
如果说液冷方案探索的是超节点的性能上限,风冷方案则是在探索超节点的普及边界。
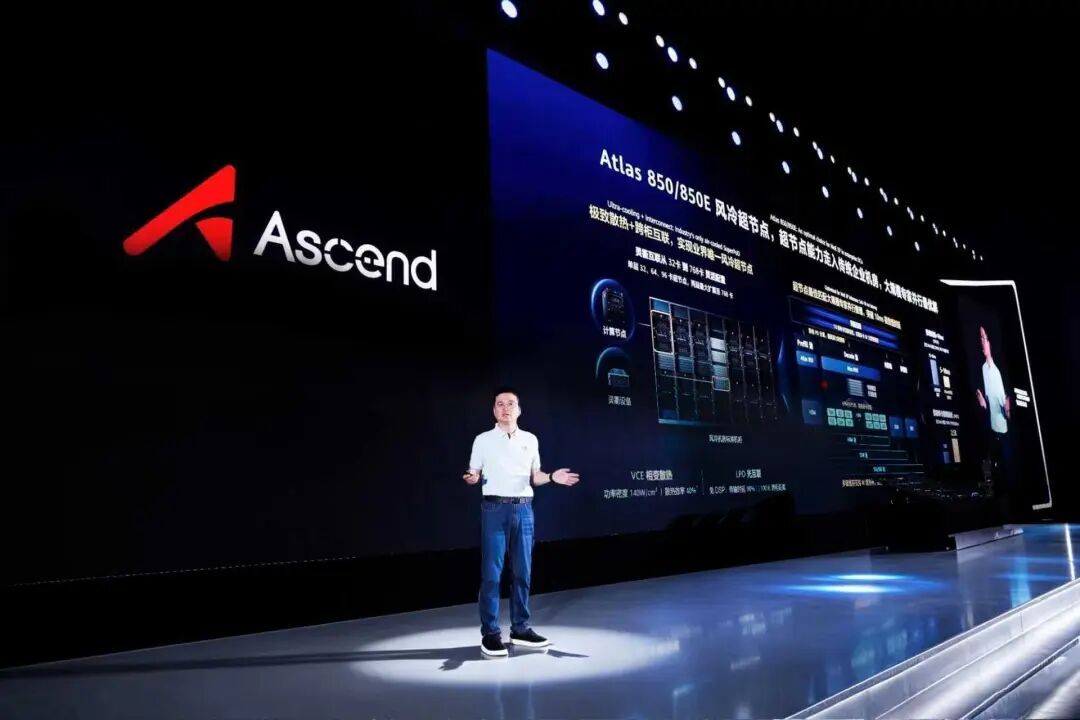
Atlas 850E 风冷超节点的核心价值,是打破了超节点的部署门槛,让超节点技术有机会下沉到传统企业机房。
在此之前,超节点基本以液冷方案为主,仅适配新建液冷数据中心。
但国内绝大多数企业仍在使用传统风冷机房,液冷改造成本高、周期长,直接将大量企业挡在了超节点技术的门外,这也是超节点难以向全行业普及的核心阻碍。
针对这个产业痛点,硬件层面,Atlas 850E采用自研VCE相变散热技术,散热效率较传统风冷提升40%以上,无需改造现有IDC基建,标准机柜即可直接上架,直接打破了此前超节点只能落地液冷机房的核心门槛。
同时它完整保留了统一内存编址等超节点核心能力,原生支持全量低精度格式,可稳定实现10ms级时延推理;组网规模也可灵活适配,从几十卡到数百卡均可平滑扩展,匹配不同规模企业的算力升级需求。
性能层面,该方案原生覆盖FP8、mxFP8、HiF8、INT8、mxFP4 全量低精格式,可稳定实现10ms级时延推理,匹配Agent多轮对话、高频KV缓存读写的负载需求,支持M级超长上下文。
通过异构PD分离方案,可根据业务负载动态调整Prefill与Decode配比,叠加大规模专家并行优化,在万亿MoE模型上实现5~10ms低时延,单卡吞吐较业界普通风冷集群提升2.5倍。
在我们看来,这类风冷方案的出现,大幅降低了超节点的使用门槛,让大量拥有传统机房的行业,能够以较低的改造成本获得超节点的架构效率红利。
超节点不再是头部科技公司的专属技术,开始有机会成为千行百业可及的通用算力基础设施,整个超节点产业的市场空间也由此打开。
透过产品看产业,能看到一个更清晰的趋势:算力行业的竞争,已经从单卡性能的比拼,进入了全链路系统能力的比拼阶段。这也是超节点时代,产业竞争最核心的变化。
在传统服务器堆叠的时代,算力方案的差异更多体现在单芯片性能上,厂商的竞争力很大程度上由芯片参数决定。
但到了超节点时代,算力是一套系统工程,芯片只是其中一个环节,竞争核心围绕四个维度展开:芯片微架构创新转向效率与易用性导向,系统软件充分释放硬件潜力同时屏蔽底层复杂度,开源生态共建决定开发者使用意愿与迁移成本,开发体验工具化降低落地门槛。
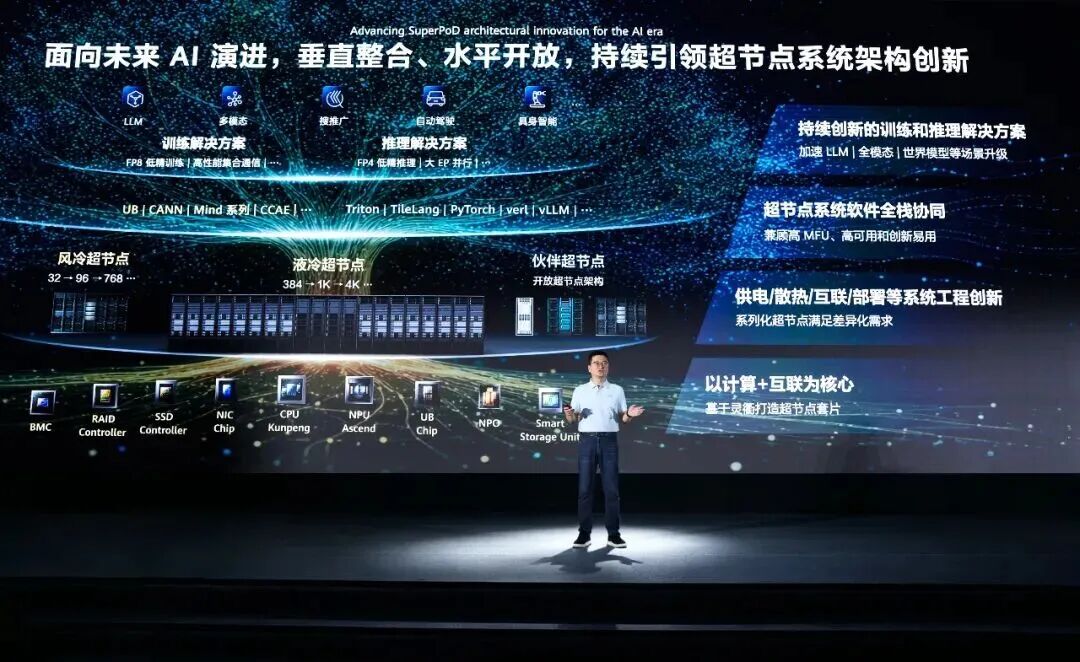
目前昇腾超节点已经在互联网、制造、金融、科研等多个领域实现落地,也从侧面验证了这套技术路线的产业价值。
在我们看来,这次昇腾950 超节点的商用,不止是一家厂商的产品更新,至少向整个行业释放了三个明确的积极信号。
第一,国内超节点赛道正式进入规模商用期。在这之前,超节点更多是头部厂商的试点项目,行业整体处于观望技术成熟度的阶段。
随着全场景产品矩阵的落地、千套级部署规模的验证、工程化细节的成熟以及跨行业案例的积累,行业已经有了可参考、可复制的商用样本。
接下来超节点赛道的竞争重心,将从参数比拼、概念验证,转向交付能力、运营稳定性、落地效果的比拼,整个赛道会向更务实、更落地的方向发展。
第二,算力竞争全面进入系统级比拼时代。单芯片性能依然是基础,但到了万卡级集群阶段,决定整体效率的早已不是单卡峰值。
架构设计、互联能力、工程可靠性、软件生态、开发者体验这些系统级能力,正在成为更核心的竞争力。这也意味着,具备全链路垂直整合能力的厂商,会在接下来的产业竞争中占据更有利的位置,整个算力行业的技术门槛会持续抬升。
第三,算力正在从补充选项走向主流供给。前几年行业讨论算力,更多关注“有没有”。而从当前的产品成熟度来看,自主创新算力在性能、稳定性、生态完备性上都在逐步追平,甚至在超节点、低精度技术等方向形成了差异化特点。
随着技术成熟度与商用落地度的持续提升,自主创新正在转变为更多客户的主流选择之一,这对整个国内算力产业的发展而言,是非常重要的积极信号。
从芯片微架构迭代,到互联架构升级,再到工程落地与生态建设,昇腾950 超节点的商用,不是单点的产品更新,是一整套端到端技术体系逐步成熟的集中体现。
当然,超节点的规模化普及才刚刚起步,接下来还要接受更多行业场景、更大部署规模的长期验证。
但可以确定的是,随着AI 负载持续向更大规模、更复杂场景演进,算力基建的架构升级是必然趋势。
而这场算力产业的竞争,已经悄然从单芯片的堆料竞赛,转向了全链路的系统能力比拼。
这次产品发布,更像是国内算力基建向更高效率、更广覆盖发展的一个缩影,也为接下来超节点产业的规模化发展,拉开了序幕。
- END –
